Comment travailler avec du code legacy
La plupart des développeurs préfèrent sans doute travailler sur des projets partant de zéro plutôt que sur du code legacy.
Pourtant la réalité est tout autre: l’essentiel du code auquel on a affaire au quotidien est du code legacy, et savoir travailler correctement avec est donc une compétence très importante.
Dans cet article, je vais donner quelques conseils pratiques à suivre chaque fois que vous devez ajouter une fonctionnalité ou corriger un bug dans une base de code legacy, sans laisser de dette technique derrière vous !
Les exemples sont en C++, mais ils se transposent facilement dans d’autres langages comme Java ou C#.
Pourquoi s’embêter avec le code legacy ?
Dans son livre incontournable « Working effectively with legacy code », Michael Feathers définit le code legacy comme du code sans tests. Selon cette définition, beaucoup de code devient legacy dès qu’il est écrit :-).
Du code sans tests est difficile à modifier sans le casser. En général, cela implique aussi que ce code est difficile à tester, parce qu’il n’est pas bien conçu.
On entre alors dans un cercle vicieux, aussi connu sous le nom de « théorie de la vitre brisée » : chaque fois que quelqu’un doit modifier du code legacy, le désordre existant n’incite pas à prendre le temps de coder proprement, et le nouveau code ne fait généralement qu’ajouter du désordre par-dessus l’existant. Le code commence alors à « pourrir », comme dit Robert Martin, et chaque nouvelle modification prend de plus en plus de temps, jusqu’au point où plus personne ne veut maintenir le code.
La tentation est alors de jeter l’éponge et de réécrire l’application from scratch, mais c’est souvent (pas toujours) une très mauvaise stratégie :
- Une refonte peut prendre beaucoup de temps (selon la complexité de l’application bien sûr), et pendant ce temps, deux systèmes doivent évoluer en parallèle : l’ancien et le nouveau
- Les clients continuent d’utiliser l’ancien système tant que le nouveau n’est pas terminé, donc l’ancien doit être maintenu de toute façon, ce qui double l’effort
- Une refonte est risquée (on ne sait jamais quand elle sera terminée) et généralement coûteuse
- La nouvelle version n’est pas forcément meilleure que la précédente, surtout si la refonte est faite dans l’urgence !
- Travailler sur le nouveau système peut être frustrant, puisque ce n’est pas celui réellement utilisé par le client
Bien sûr, dans certains cas, le code legacy est dans un état de décomposition si avancé qu’il vaut mieux le jeter complètement, mais très souvent il est plus efficace – et plus gratifiant – de le nettoyer progressivement que de tout réécrire de zéro.
Travailler correctement avec du code legacy fait appel à de nombreuses compétences, comme :
- Les tests unitaires
- Les mocks
- Le refactoring
- Le Clean Code
- La conception logicielle
Je vais essayer de donner un aperçu de tout cela dans cet article !
Identifier ce qu’il faut modifier
La première chose à faire quand on travaille sur du code legacy est d’identifier quelles parties du code sont impactées par la fonctionnalité (ou la correction de bug) à implémenter.
Les impacts sur le code existant peuvent être classés ainsi :
- Les impacts directs correspondent au code responsable du bug que l’on cherche à corriger, ou au code qu’il faut étendre pour implémenter une nouvelle fonctionnalité
- Les impacts indirects sont toutes les modifications qu’il faut faire uniquement en conséquence des précédentes, généralement de façon inattendue, alors qu’elles n’ont pas de rapport direct avec ce que l’on voulait faire
Un exemple d’impact indirect : on doit modifier la structure d’une classe (par exemple changer la signature d’une méthode ou renommer un champ), et cela casse immédiatement des dizaines d’autres classes dont on ne soupçonnait même pas l’existence.
Si l’on est capable de dessiner le graphe de dépendances des composants (par exemple les classes) du code, les impacts peuvent ressembler à ceci :
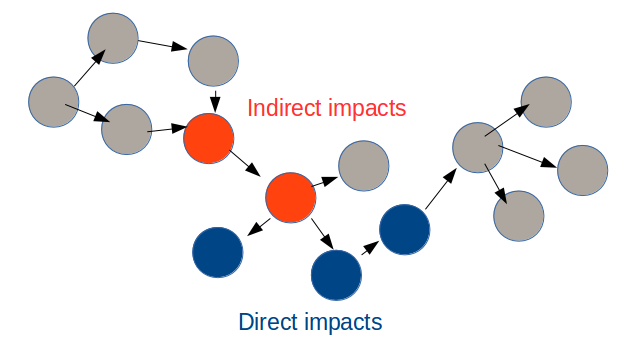
À ce stade, il est important de remarquer qu’une bonne conception respectant les principes de forte cohésion et de faible couplage a une grande influence sur le nombre d’impacts :
- Une forte cohésion du code garantit que les impacts directs sont concentrés au même endroit dans le code (même méthode, même classe, même module)
- Un faible couplage entre composants (méthodes et classes) minimise le nombre d’impacts indirects
Malheureusement, ce sont justement ces bonnes pratiques qui sont souvent absentes du code legacy, donc vous aurez beaucoup d’impacts à gérer 😉 .
Mettre en place un harnais de tests
Une fois les impacts identifiés, il est essentiel de minimiser le risque de casser le code existant en mettant en place un « harnais de tests » autour de lui, s’il n’en existe pas déjà un.
Par définition, le code legacy n’a pas de tests et / ou est difficile à tester, donc ce ne sera pas une tâche facile !
Il existe deux grands types de tests :
- Les tests unitaires, qui testent des classes individuelles de façon isolée
- Les tests d’intégration, qui testent plusieurs classes ensemble, avec éventuellement, dans le pire des cas, des dépendances vers des systèmes externes
Il y a plusieurs bonnes raisons de préférer les tests unitaires aux tests d’intégration :
- Les tests unitaires s’exécutent plus vite que les tests d’intégration, donc ils donnent un retour plus rapide quand quelque chose est cassé
- Il est plus facile d’écrire des tests exhaustifs avec des tests unitaires, et en particulier de couvrir les cas d’erreur
- Un bon test unitaire ne devrait avoir qu’une seule raison d’échouer, ce qui permet de trouver facilement la cause du problème quand le test échoue. À l’inverse, plus un test d’intégration fait intervenir de composants, plus il est difficile de remonter à l’origine d’un échec
- Une fois en place, les tests unitaires servent de documentation technique de bas niveau pour les futurs lecteurs du code
Les tests d’intégration sont toutefois nécessaires aussi, pour s’assurer que tout fonctionne toujours ensemble, mais idéalement le périmètre des tests d’intégration à mettre en place devrait se limiter à la zone du code impacté.
En pratique, le périmètre de test minimal que l’on peut mettre en place facilement est généralement plus large que le périmètre idéal, ce qui signifie que les tests couvriront plus de code que nécessaire.
Il arrive souvent qu’une partie du système à tester dépende d’un système externe, comme une base de données ou un web service, qui peut être lent et / ou peu fiable. Pour rendre le système plus facilement testable, ces dépendances externes doivent être mockées (ou stubbées), c’est-à-dire remplacées par de faux composants au comportement déterministe.
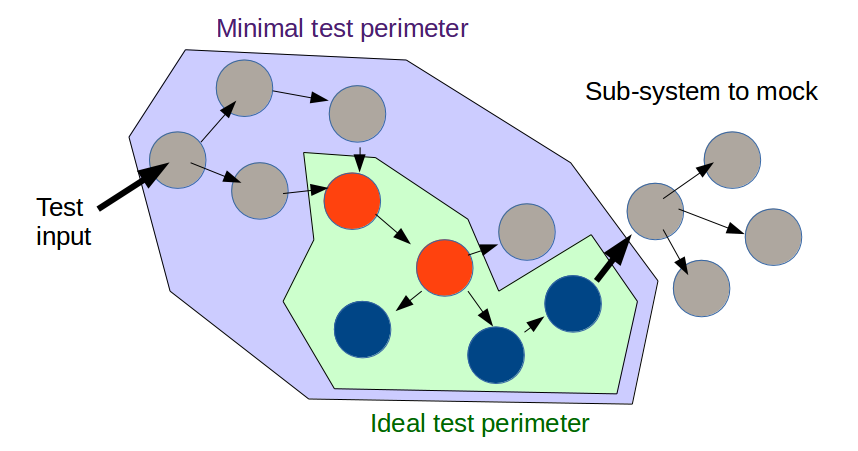
Le problème, c’est qu’il n’est pas toujours possible de mocker les dépendances externes, à cause d’un fort couplage dans le code (aussi appelé « code spaghetti »).
Pour la même raison, il est souvent très difficile d’écrire des tests unitaires pour du code legacy, et écrire un harnais de tests avant de toucher au code ressemble à une mission impossible.
On se retrouve alors face à un problème de l’œuf et de la poule : pour modifier le code en toute sécurité, il faut d’abord écrire des tests, mais pour pouvoir écrire des tests, il faut modifier le code !
Une solution à ce problème est de suivre cette méthode :
- Trouver le périmètre testable minimal (test d’intégration ou de bout en bout), dans le pire des cas au niveau de l’interface utilisateur
- Si par chance votre application a déjà une suite de tests fonctionnels de non-régression (automatisée ou non), tant mieux, c’est déjà un bon début !
- Sinon, il faudra écrire cette suite de tests vous-même, en envoyant des entrées au système et en enregistrant les sorties obtenues. Ces sorties serviront de référence pour détecter les régressions
- Utiliser ensuite des techniques sûres de cassage de dépendances (expliquées plus bas) pour couper les dépendances aux systèmes externes et réduire le plus possible le périmètre de test. L’idée est de faire des modifications minimales du code pour le rendre testable, sans prendre trop de risques
- Recommencer tout le processus (encore et encore), jusqu’à pouvoir écrire des tests unitaires autour du code impacté
L’idée est de commencer par des tests à large périmètre, plus faciles à écrire mais peu sûrs, comme harnais de sécurité minimal avant de toucher au code.
Au fur et à mesure que vous coupez des dépendances (que vous réduisez le couplage) dans le code, vous pourrez écrire des tests plus ciblés, qui vous donneront plus de confiance pour faire des modifications plus intrusives dans le code sans risquer de casser le comportement existant.
Couverture
Quelle couverture de code (pourcentage de lignes de code couvertes par des tests) faut-il pour travailler en toute sécurité sur du code existant ? 80 % ? 90 % ? 99 % ?
En réalité, l’objectif idéal ne devrait pas être 100 % de couverture de lignes (la métrique habituelle), mais 100 % de couverture d’assertions !
En effet, couvrir une ligne de code de production par un test (unitaire ou d’intégration) ne signifie pas que l’effet de cette ligne est correctement vérifié par le test. Une couverture de lignes de 100 % ne garantit en rien que vos tests détecteront le moindre bug, si ces tests n’ont pas les assertions nécessaires (c’est-à-dire des vérifications que le comportement du code est bien celui attendu). La couverture d’assertions est par définition inférieure à la couverture de lignes : une forte couverture de lignes n’est donc pas un objectif pertinent en soi, mais une faible couverture de lignes n’est pas bon signe. Au final, 40 % de couverture de lignes et d’assertions vaut bien mieux que 99 % de couverture de lignes avec 5 % de couverture d’assertions.
Refactorer pour casser les dépendances
Dépendances et couplage fort
Reprenons le graphe de dépendances du code legacy que nous devons modifier :
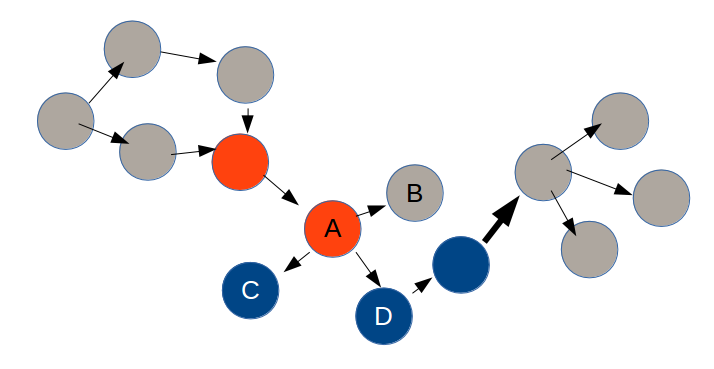
Dans ce graphe, chaque flèche représente une dépendance de code source. Par exemple, la classe A dépend des classes B, C et D, ce qui signifie par exemple que toute modification du code de la classe C entraînera une autre modification dans la classe A (ou à tout le moins, une recompilation).
Mais il existe un autre type de dépendance, appelé dépendance à l’exécution, lié aux appels de fonctions. Si une méthode de la classe A appelle une méthode de la classe B, on a une dépendance à l’exécution de A vers B.
Dans du code procédural, dépendances de code source et dépendances à l’exécution sont identiques, car la structure du code reflète exactement le flot d’exécution.
Par exemple, supposons que nous ayons une classe Alarm, dont le rôle est de déclencher une alarme quand la valeur renvoyée par un capteur (Sensor) sort d’un intervalle donné :
class Sensor {
public:
  float getValue() const;
};

class Alarm {
public:
  void check();
private:
  Sensor _sensor;
};

void Alarm::check() {
  float currentValue = _sensor.getValue();
  if (currentValue < ... or currentValue > ...) {
    // trigger alarm
  }
}
Ici, on a une dépendance de code source de Alarm vers Sensor, car la classe Alarm contient directement un champ de type Sensor. Elle a aussi une dépendance à l’exécution vers Sensor, car :
- le constructeur de Alarm appelle le constructeur de Sensor
Alarm::check()appelleSensor::getValue()
Ce genre de code est extrêmement fréquent, et rend la classe Alarm impossible à tester unitairement correctement !
En effet, il y a un couplage fort entre Alarm et Sensor, et il n’y a aucun moyen de tester Alarm seule, sans appeler getValue sur une vraie instance de Sensor, ce qui peut déclencher un appel à un système externe au comportement imprévisible.
Et au passage, tester la classe Alarm fera peut-être sonner une vraie alarme dans votre immeuble, ce que vous n’aurez sans doute pas envie de faire plus d’une fois 😉 .
Le principe d’inversion des dépendances
Une solution à ce problème de couplage est de suivre le principe d’inversion des dépendances (à ne pas confondre avec l’injection de dépendances, qui est un peu différente) :
Principe d’inversion des dépendances
Les modules de haut niveau ne doivent pas dépendre des modules de bas niveau. Les deux doivent dépendre d’abstractions.
Les abstractions ne doivent pas dépendre des détails. Les détails doivent dépendre des abstractions.
Qu’est-ce que cela signifie ? Dans l’exemple précédent, cela signifie que Alarm ne doit pas dépendre de la classe concrète Sensor, mais d’une interface, disons AlarmSensor :
class AlarmSensor {
public:
  virtual ~AlarmSensor() {}
  virtual float getValue() const = 0;
};

class Alarm {
public:
  void check();
private:
  AlarmSensor *_sensor;
};

void Alarm::check() {
  float currentValue = _sensor->getValue();
  if (currentValue < ... or currentValue > ...) {
    // trigger alarm
  }
}

class Sensor: public AlarmSensor {
public:
  float getValue() const override;
};
Avec cette petite modification du code, _sensor->getValue() est maintenant un appel à une méthode virtuelle sur une instance de l’interface AlarmSensor, au lieu d’un appel figé à Sensor::getValue().
Il est donc désormais possible d’écrire un test unitaire pour Alarm, en écrivant une implémentation spécifique de AlarmSensor et en l’utilisant dans le test.
Au fait, pourquoi cette manœuvre s’appelle-t-elle « inversion » de dépendances ? Rappelez-vous qu’au départ, nous avions du code procédural dans lequel la dépendance de code source allait dans le même sens que la dépendance à l’exécution :
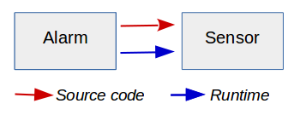
Avec l’introduction de l’interface AlarmSensor, la dépendance de code source de Alarm vers Sensor est maintenant inversée, dans le sens opposé à la dépendance à l’exécution :
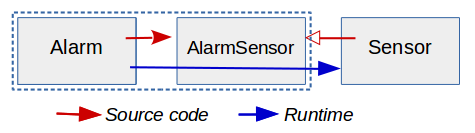
Un autre avantage de ce changement de conception est que l’interface AlarmSensor peut maintenant spécifier exactement quelles méthodes sont nécessaires à Alarm (getValue dans cet exemple). Si l’implémentation concrète Sensor a d’autres méthodes publiques, cela ne regarde pas Alarm, et grâce à l’interface AlarmSensor, les détails d’implémentation de Sensor restent cachés.
Séparer l’utilisation de la construction
L’inversion des dépendances ne suffit pas à résoudre le problème de couplage.
Alarm a maintenant un champ pointeur vers un objet AlarmSensor, mais comment ce pointeur est-il initialisé ?
Pour conserver le même comportement qu’avant, une vraie instance de Sensor doit être créée quelque part, par exemple dans le constructeur de Alarm :
Alarm::Alarm() {
  _sensor = new Sensor();
}
Mais si on fait cela, on a toujours une dépendance de code source de Alarm vers Sensor, et le problème n’est qu’à moitié résolu.
Une solution propre est d’utiliser l’injection de dépendances, qui consiste à injecter l’objet AlarmSensor dans le constructeur de Alarm (laissons de côté les questions de gestion mémoire pour l’instant) :
Alarm::Alarm(AlarmSensor& sensor): _sensor(&sensor) {
}
Cela suit un principe général de conception qui est la séparation de l’utilisation et de la construction : au lieu de laisser Alarm instancier elle-même le Sensor dont elle a besoin, cette responsabilité est sortie de Alarm, et le code client de production ressemble maintenant à ceci :
Sensor sensor;
Alarm alarm(sensor);
alarm.check();
Grâce à l’injection de dépendances, il est facile d’écrire un test unitaire, en utilisant par exemple un stub de AlarmSensor :
class StubSensor: public AlarmSensor {
public:
  float getValue() override { return _value; }
  void setValue(float value) { _value = value; }
private:
  float _value = 0;
}

// Unit test code
StubSensor sensor;
Alarm alarm(sensor);
alarm.check(); // Alarm should not be triggered
sensor.setValue(42);
alarm.check(); // Alarm should be triggered
Écrire une classe stub comme celle-ci peut vite devenir pénible s’il y a plusieurs méthodes dans l’interface.
Une autre solution est d’utiliser un framework de mock comme la bibliothèque Google Mock, qui rend le code de test plus facile à écrire et plus élégant :
class MockSensor: public AlarmSensor {
public:
  MOCK_CONST_METHOD0(getValue, float());
};

// Unit test code
MockSensor sensor;
Alarm alarm(sensor);
alarm.check(); // Alarm should not be triggered
ON_CALL(sensor, getValue()).WillByDefault(Return(42));
alarm.check(); // Alarm should be triggered
Préserver la rétrocompatibilité
Modifier le constructeur de Alarm comme décrit est un changement assez intrusif : cela implique que tous les clients de Alarm doivent maintenant modifier leur code pour instancier eux-mêmes un Sensor et utiliser le nouveau constructeur.
Quand on travaille sur du code legacy, on ne veut généralement pas tout casser de la sorte ; c’est donc souvent une bonne idée de préserver la compatibilité au niveau du code source avec le code existant (dans un langage comme le C++, il faut aussi penser à la compatibilité binaire, mais celle-ci n’est pas toujours facile à conserver).
Dans notre exemple, il est facile de préserver la compatibilité des sources, en gardant un constructeur par défaut qui instancie Sensor comme avant :
class Alarm {
public:
  // Legacy constructor
  Alarm(): _sensor(make_shared<Sensor>()) {}
  // New constructor
  Alarm(shared_ptr<AlarmSensor> sensor): _sensor(sensor) {}
  void check();

private:
  shared_ptr<AlarmSensor> _sensor;
};
(ici un shared_ptr a été utilisé à la place d’un pointeur brut pour simplifier la gestion de la mémoire)
Traiter le code procédural
L’injection de dépendances fonctionne bien dans du code orienté objet, mais on doit parfois faire face à du code procédural, qui utilise des choses comme :
- Des fonctions globales
- Des appels de méthodes statiques
- Des variables globales
- Des singletons (qui ne sont que des objets globaux déguisés)
Imaginons que notre méthode Alarm::check() ait été écrite ainsi :
void Alarm::check() {
  float currentValue = Sensor::GetValue();
  if (currentValue < ... or currentValue > ...) {
    // trigger alarm
  }
}
Avec ce code, impossible de jouer sur les interfaces et le polymorphisme pour casser la dépendance, il faut donc trouver une autre solution.
Une option simple est d’extraire l’appel à la méthode statique dans une méthode virtuelle dédiée :
class Alarm {
...
protected:
  virtual float getSensorValue();
};

void Alarm::check() {
  float currentValue = getSensorValue();
  if (currentValue < ... or currentValue > ...) {
    // trigger alarm
  }
}

float Alarm::getSensorValue() {
  return Sensor::GetValue();
}
Il est alors possible de redéfinir cette nouvelle méthode dans un test unitaire en dérivant Alarm, par exemple comme ceci :
class TestableAlarm: public Alarm {
public:
  void setSensorValue(value) { _sensorValue = value; }
protected:
  float getSensorValue() override { return _sensorValue; }
private:
  float _sensorValue;
};

// Unit test code
TestableAlarm alarm;
alarm.check(); // Alarm should not be triggered
alarm.setSensorValue(42);
alarm.check(); // Alarm should be triggered
Là encore, il est plus simple de définir une classe mock avec Google Mock que d’écrire la classe testable à la main :
class TestableAlarm: public Alarm {
public:
  MOCK_METHOD0(getSensorValue, float());
};

// Unit test code
TestableAlarm alarm;
alarm.check(); // Alarm should not be triggered
ON_CALL(alarm, getSensorValue()).WillByDefault(Return(5));
alarm.check(); // Alarm should be triggered
Extraire une méthode de fabrique
La technique d’extraction de méthode est très générale, et peut servir dans de nombreuses situations.
Imaginons que lorsque l’alarme est déclenchée, elle crée un objet AlarmRinger et l’appelle comme ceci :
void Alarm::trigger() {
  AlarmRinger ringer;
  ringer.ring();
};
Cela rendra les tests unitaires pénibles, car on ne veut faire sonner aucune alarme dans un test !
La solution est d’extraire une méthode de fabrique (factory method), pour séparer l’utilisation de ringer de sa construction :
class Alarm {
...
protected:
  virtual unique_ptr<AlarmRinger> getRinger();
private:
  void trigger();
};

void Alarm::trigger() {
  auto ringer = getRinger(); // Delegate construction
  ringer->ring();
};

unique_ptr<AlarmRinger> Alarm::getRinger() {
  return make_unique();
};
Il est maintenant possible de redéfinir la méthode Alarm::getRinger() dans un test unitaire, pour renvoyer une instance spécifique de AlarmRinger. Il faudra aussi extraire une interface pour AlarmRinger si vous ne pouvez pas en instancier une vraie dans votre test (inversion des dépendances).
Nettoyer le code
Pourquoi un code propre est important
Dès que votre code legacy est couvert par une suite de tests correcte, vous pouvez travailler dessus en toute sécurité et ajouter de nouvelles fonctionnalités (ou corriger des bugs) selon vos besoins. Cependant, avant d’y toucher, vous devriez d’abord nettoyer le code existant.
Que signifie nettoyer le code ? Un code propre est un code facile à lire, à comprendre et à maintenir.
Évidemment, le code legacy n’est généralement pas très propre, donc votre travail ne consiste pas seulement à écrire du nouveau code propre, mais aussi à nettoyer l’ancien. Voici quelques bonnes raisons de le faire :
- Comprendre du code legacy est difficile et prend du temps. En le nettoyant, vous le rendez plus facile à comprendre pour vous-même, et pour tout futur développeur (peut-être vous-même dans le futur) qui devra travailler sur le même code
- Les fonctionnalités sont plus faciles et plus rapides (donc moins chères) à ajouter dans du code propre
- Vous faciliterez la tâche de vos collègues qui devront faire la revue de code de votre travail
- Vous remboursez une partie de la dette technique du code legacy, ce qui éloigne la nécessité d’une refonte complète
- Un code propre a moins de bugs (vous pourriez découvrir des bugs cachés en nettoyant le code !)
Essayez de toujours appliquer la « règle du boy-scout » : toujours laisser le code plus propre que vous ne l’avez trouvé.
La façon la plus efficace de nettoyer du code legacy est d’appliquer des techniques de refactoring, c’est-à-dire de petites transformations du code qui ne modifient pas son comportement.
Le refactoring peut se faire de façon plus ou moins sûre selon la situation (et selon le langage / les outils utilisés), mais de toute façon votre code est censé être déjà couvert par des tests, pour minimiser les risques.
Du code lisible
Dans le code legacy, il est courant de trouver des fonctions de plusieurs centaines de lignes et des classes de plusieurs milliers de lignes, qui vous promettent de longues heures passées devant votre écran à essayer de comprendre ce que fait le code.
Pour être lisible, une fonction doit être courte, de l’ordre de quelques lignes de code, pour que le lecteur comprenne immédiatement ce qu’elle fait. Les classes doivent aussi être petites ; une classe trop grosse est généralement le signe qu’elle fait trop de choses et que sa responsabilité n’est pas claire.
Il est aussi essentiel d’utiliser des noms significatifs pour les classes, les méthodes et les variables, afin de communiquer l’intention du code et de le rendre facile à lire.
Quand vous lisez du code legacy et que vous tombez sur quelque chose qui n’est pas clair (cela devrait arriver très souvent !), n’hésitez pas à renommer fonctions et variables (votre IDE est votre ami) pour documenter votre nouvelle compréhension du code. Il vaut bien mieux nettoyer le code qu’écrire des commentaires, car les commentaires peuvent devenir obsolètes, voire trompeurs.
Éliminer la duplication en augmentant l’abstraction
L’un des objectifs les plus importants du refactoring est d’éliminer la duplication dans le code.
La duplication peut être un simple copier / coller des mêmes lignes dans une méthode donnée, auquel cas la solution est souvent un refactoring d’extraction de méthode, qui consiste à isoler le code dupliqué dans une nouvelle méthode.
Extraire des méthodes est très facile (surtout si votre IDE sait le faire automatiquement) et puissant. Attention cependant à ne pas le faire trop tôt : une fois une méthode extraite, il peut être difficile d’identifier la duplication restante, répartie sur plusieurs méthodes.
Prenons par exemple ce bout de code :
void Order::updatePrice(Item& item) {
  if (_customer.isEligibleForDiscount() && item.quantity > 5000) {
    item.price = item.price * (1 - item.highDiscountRate);
  } else if (_customer.isEligibleForDiscount() && item.quantity > 1000) {
    item.price = item.price * (1 - item.mediumDiscountRate);
  } else if (_customer.isEligibleForDiscount() && item.quantity > 100) {
    item.price = item.price * (1 - item.lowDiscountRate);
  }
}
Ici, toutes les instructions if sont très similaires, mais pas identiques, donc on ne peut pas simplement appliquer le refactoring d’extraction de méthode.
C’est une situation fréquente dans le code legacy, et le secret du refactoring est de trouver un moyen de transformer du code similaire en code identique, autrement dit d’élever le niveau d’abstraction.
Cette transformation peut / doit se faire progressivement, à petits pas. Une méthode possible est de suivre ce que Sandi Metz appelle les « Flocking Rules » :
Les Flocking Rules
- Règle n°1 : trouver les éléments qui se ressemblent le plus
- Règle n°2 : choisir la plus petite différence entre eux
- Règle n°3 : faire le plus petit changement qui supprime cette différence
et appliquer ces règles encore et encore.
Dans notre exemple, on voudrait rendre des expressions comme item.highDiscountRate et item.mediumDiscountRate identiques, et pas seulement similaires.
Une façon simple d’obtenir du code identique est de créer par exemple un tableau de taux de remise dans la classe Item, ce qui donne un code comme celui-ci :
void Order::updatePrice(Item& item) {
  if (_customer.isEligibleForDiscount() && item.quantity > 5000) {
    int discountIndex = 0;
      item.price = item.price * (1 - item.discountRate[discountIndex]);
    } else if (_customer.isEligibleForDiscount() && item.quantity > 1000) {
      int discountIndex = 1;
      item.price = item.price * (1 - item.discountRate[discountIndex]);
    } else if (_customer.isEligibleForDiscount() && item.quantity > 100) {
      int discountIndex = 2;
      item.price = item.price * (1 - item.discountRate[discountIndex]);
   }
}
Et voilà ! Le code qui était similaire est maintenant identique, et nous avons fait cette transformation sans modifier le comportement.
Notez qu’à première vue, le code semble encore pire qu’avant : il a plus de lignes et contient plus de duplication ! C’est quelque chose de très fréquent pendant un refactoring : le niveau de duplication augmente temporairement, mais ce n’est en fait qu’un moyen de révéler une duplication cachée, pour pouvoir la supprimer plus facilement ensuite.
En effet, il est maintenant très facile d’éliminer la duplication en extrayant une méthode applyDiscount, comme ceci :
void Order::updatePrice(Item& item) {
  if (_customer.isEligibleForDiscount() && item.quantity > 5000) {
    applyDiscount(item, 0);
  } else if (_customer.isEligibleForDiscount() && item.quantity > 1000) {
    applyDiscount(item, 1);
  } else if (_customer.isEligibleForDiscount() && item.quantity > 100) {
    applyDiscount(item, 2);
  }
}

void Order::applyDiscount(Item& item, int discountIndex) {
  item.price = item.price * (1 - item.discountRate[discountIndex]);
}
ou même :
void Order::updatePrice(Item& item) {
  int quantity = item.quantity;
  if (quantity > 5000) {
    applyDiscount(item, 0);
  } else if (quantity > 1000) {
    applyDiscount(item, 1);
  } else if (quantity > 100) {
    applyDiscount(item, 2);
  }
}

void Order::applyDiscount(Item& item, int discountIndex) {
  if (_customer.isEligibleForDiscount()) {
    item.price = item.price * (1 - item.discountRate[discountIndex]);
  }
}
Attention à la Feature Envy
Le refactoring précédent par extraction de méthode est parfaitement valide, mais il passe encore à côté de l’essentiel : la classe Order connaît trop de choses sur le fonctionnement interne de Item, ce que Martin Fowler appelle la « feature envy » (jalousie de fonctionnalité).
Quand on voit une classe manipuler sans cesse les méthodes (ou pire, les champs) d’une autre classe, c’est souvent le signe que le code n’est pas au bon endroit.
Dans l’exemple précédent, il est bien plus propre de déplacer tout le code dans la classe Item :
void Order::updatePrice(Item& item) {
  if (_customer.isEligibleForDiscount()) {
    item.applyDiscount();
  }
}

void Item::applyDiscount() {
  if (_quantity > 5000) {
    applyDiscountRate(0);
  } else if (_quantity > 1000) {
    applyDiscountRate(1);
  } else if (_quantity > 100) {
    applyDiscountRate(2);
  }
}

void Item::applyDiscountRate(int discountIndex) {
  _price *= (1 - discountRate[discountIndex]);
}
C’est déjà mieux, mais il reste de la duplication dans la méthode applyDiscount, puisque le motif if (quantity > x) applyDiscountRate(y) est répété 3 fois.
On peut supprimer cette duplication en transformant la série de if en boucle for :
const array<int, 3> Item::DISCOUNT_THRESHOLDS = {5000, 1000, 100};
const array<float, 3> Item::DISCOUNT_RATES = {0.7, 0.8, 0.9};

void Item::applyDiscount() {
  for (int i = 0; i < DISCOUNT_THRESHOLDS.size(); i++) {
    if (_quantity > DISCOUNT_THRESHOLDS[i]) {
      applyDiscountRate(i);
      break;
    }
  }
}

void Item::applyDiscountRate(int discountIndex) {
  _price *= (1 - DISCOUNT_RATES[discountIndex]);
}
Voici un cas qui montre qu’une extraction de méthode prématurée peut parfois masquer de la duplication. Si on inline la méthode applyDiscountRate :
const array<int, 3> Item::DISCOUNT_THRESHOLDS = {5000, 1000, 100};
const array<float, 3> Item::DISCOUNT_RATES = {0.7, 0.8, 0.9};

void Item::applyDiscount() {
  for (int i = 0; i < DISCOUNT_THRESHOLDS.size(); i++) {
    if (_quantity > DISCOUNT_THRESHOLDS[i]) {
      _price *= (1 - DISCOUNT_RATES[i]);
      break;
    }
  }
}
on voit plus facilement qu’il y a en fait une classe Discount cachée dans Item. En créant cette classe manquante, on obtient quelque chose comme :
const array<Discount, 3> Item::DISCOUNTS = {
  Discount(5000, 0.7),
  Discount(1000, 0.8),
  Discount(100, 0.9}
}

void Item::applyDiscount() {
  for (const auto& discount: DISCOUNTS) {
    if (_quantity > discount.threshold) {
      _price *= (1 - discount.rate);
      break;
    }
  }
}
Le refactoring est-il terminé ? Le code est déjà assez propre, mais la classe Item a encore besoin d’accéder aux champs internes de Discount, ce qui n’est pas vraiment nécessaire. En déplaçant une partie de la logique dans Discount elle-même, on obtient une meilleure conception orientée objet :
void Item::applyDiscount() {
  for (const auto& discount: DISCOUNTS) {
    if (discount.isAboveThreshold(_quantity)) {
      discount.applyTo(_price);
      break;
    }
  }
}

bool Discount::isAboveThreshold(int quantity) const {
  return quantity > _threshold;
}

void Discount::applyTo(float& price) const {
  price *= (1 - _rate);
}
Quand s’arrêter ?
À ce stade, la responsabilité d’appliquer la bonne remise incombe toujours à Item. Il est possible de déplacer cette responsabilité dans Discount elle-même :
void Item::applyDiscount() {
  for (const auto& discount: DISCOUNTS) {
    if (discount.applyIfAboveThreshold(_quantity, _price))
    break;
  }
}

bool Discount::applyIfAboveThreshold(int quantity, float& price) {
  if (isAboveThreshold(quantity)) {
    applyTo(price);
    return true;
  }
  return false;
}
mais cela ne simplifie pas vraiment le code : ici, on est sans doute allé trop loin !
Le refactoring peut être un processus sans fin, donc à un moment il faut trouver un bon équilibre entre principes de conception et lisibilité.
Kent Beck a donné quelques repères pour savoir quand arrêter de refactorer, appelés les « quatre règles de la conception simple ». On peut arrêter le refactoring quand le code :
- Passe ses tests
- Minimise la duplication
- Maximise la clarté
- Contient le moins d’éléments possible
Références
- « Working Effectively with Legacy Code », Michael C. Feathers
- « Clean Code, a Handbook of Agile Software Craftsmanship », Robert C. Martin
- « Essential Skills for the Agile Developer », Alan Shalloway et al.
- « Growing Object-Oriented Software, Guided by Tests », Steve Freeman et Nat Pryce
- « Refactoring: Improving the Design of Existing Code », Martin Fowler et al.
- « Test-Driven Development, by Example », Kent Beck
- « 99 Bottles of OOP », Sandi Metz et Katrina Owen